一个叫 Bun 的 JavaScript 运行时,把 50 万行 Zig 代码用 AI 在 11 天内重写成了 Rust,花了 16.5 万美元 API 费用。
但几乎在同一时间,另一个叫 Roc 的编程语言团队,花了 487 天人工把 30 万行 Rust 编译器重写成了 Zig。更反直觉的是,他们说 Zig 版本的内存 bug 反而更少。
双向奔赴?
1. Bun 的野心与 Zig 的起点
Bun 的创始人 Jarred Sumner 选 Zig 的原因很直接——看到了 Zig 的语言参考文档,被它的底层控制能力和性能追求打动了。
Bun 的野心从一开始就很大:
- JavaScript/TypeScript/CSS 转译器、压缩器、打包器
- 兼容 npm 的包管理器
- 类 Jest 的测试运行器
- Node.js & TypeScript 兼容的模块解析
- HTTP/1.1 & WebSocket 客户端
- Node.js API 实现(fs、net、tls 等几十个模块)
一个人,一年,在奥克兰的一个小公寓里,没有 LLM 辅助,用 Zig 写了初版 Bun。Jarred 自己说:“如果不是 Zig,我不可能在一年内做出这么多功能。”
但到了 2026 年,Bun 已经有 2200 万月下载量,Claude Code 和 OpenCode 依赖它,Vercel、Railway、DigitalOcean 都有一等支持。
规模上去了,bug 自然也跟着来了。
2. 触目惊心的 Bug 清单
看看 Bun v1.3.14(最后一个 Zig 版本)修复的 bug 清单:
1
2
3
4
5
6
7
8
9
10
11
12
13
- node:zlib 中调用 .reset() 时的 heap-use-after-free 崩溃
- node:zlib 中 onerror 回调触发重入 write() 后 close() 的 use-after-free
- node:http2 中重入 JS 回调触发 hashmap rehash 导致内部流指针失效的 use-after-free
- UDPSocket.send() 中 valueOf()/toString() 回调分离 ArrayBuffer 的 use-after-free
- Buffer#copy 和 Buffer#fill 中 valueOf 回调分离 ArrayBuffer 的越界读写
- UDPSocket.sendMany() 中连接状态变化导致越界写
- crypto.scrypt 中回调和密码/盐缓冲区永远不释放的内存泄漏
- SSLWrapper.init 错误路径上 strdup 的密码短语泄漏
- tlsSocket.setSession() 每次调用泄漏一个 SSL_SESSION(~6.5KB/次)
- fs.watch() 的 watcher 永远不被 GC,引用计数下溢永久钉住每个 watcher 作为 GC 根
- CSS 解析器中 background-clip 有厂商前缀和多层背景时的 double-free
- DuplexUpgradeContext 永远不释放——每次 tls.connect({ socket: duplex }) 泄漏一次
- MessageEvent 中 GC 标记线程从 BroadcastChannel 或 MessagePort 观察到撕裂变体的竞态崩溃
这些 bug 有一个共同特征:几乎全是 use-after-free、double-free 和内存泄漏。
3. GC + 手动内存 = 灾难配方
为什么 Bun 的内存 bug 这么多?
JavaScript 是一门带垃圾回收(GC)的语言。Bun 底层用的是 JavaScriptCore(Safari 的 JS 引擎),它有自己的 GC 机制。而 Zig 跟 C 一样,不帮你管内存,需要自己分配和释放。
两套内存管理机制混在一起,就出了大问题。
每一块内存,你都得时刻想清楚:
- 这是 GC 管的还是手动管的?
- 这个指针对 conservative stack scanner 可见吗?
- 如果 JavaScript 抛异常了,这段内存释放了吗?
- 如果 JS 回调把它 detach 了,native 侧还拿着悬空指针吗?
Zig 的设计哲学是“没有隐藏的控制流”,所以它用 defer 关键字来做清理——你得显式写出“这个 scope 结束时执行什么”。
对比一下三种语言的清理机制:
| 语言 | 清理机制 | 特点 |
|---|---|---|
| Zig | defer / errdefer |
显式调用,靠人工判断时机 |
| C++ | ~Destructor / 移动语义 |
隐式触发,但容易漏 |
| Rust | Drop trait |
编译器保证,离开 scope 自动调用 |
Zig 的问题在于:当你把同一个 *T 传给很多函数时,你怎么知道它什么时候不再被引用、可以释放了?
Bun 的做法是一个“三件套”:
- arena 生命周期管理
- 引用计数
- 真的认真看
但 style guide 的问题是执行靠人,code review 加 linter 都是 best-effort。
Rust 的 Drop trait 不一样——它把“什么时候清理”变成了编译器的问题,不是你的问题。
在 Rust 的 safe 子集里,use-after-free、double-free、忘记释放——这些全是编译错误,不是运行时崩溃。
这就是 Jarred 选 Rust 的根本原因:编译错误比 style guide 的反馈回路更好。
4. AI 真正的至暗时刻:把 Zig 的栈式协程塞进 Rust 的无栈 Future
前面讲的都是内存安全的坑,但 AI 迁移最惊险的部分其实是异步模型的翻译。
Zig 的异步是栈式协程(Stackful)——每个异步函数有自己的独立栈帧,async 调用会分配一个完整的调用帧,await 挂起和恢复都由运行时管理,不需要开发者操心栈的布局。
Rust 的异步是无栈协程(Stackless)——async fn 编译成一个 Future 状态机,没有独立栈帧,状态转换靠编译器生成的 enum 变体。这带来了一个棘手的问题:Future 可能需要自引用(状态机里持有对自己栈上数据的引用),所以必须用 Pin 来固定内存地址,防止被 move 后引用失效。
把 Zig 的隐式异步帧机械翻译成 Rust 的显式 Future 状态机,意味着 AI 要:
- 为每个 Zig
async fn手动构造等价的 Rust 状态机 - 在所有跨
await点的地方插入Pin<Box<dyn Future>> - 处理 Zig 隐式分配器参数 → Rust 显式
Context的映射
能在 11 天内把 50 万行 Zig 异步代码转成 Rust 且通过测试,这才是这次迁移技术含量最高的部分,比解决 borrow checker 难得多。
5. 迁移过程与对抗式审查
大型项目的语言迁移很麻烦,但 Anthropic 收购了 Bun,他能用到预发布版的 Claude Fable 5。
系统化方案:机械移植
增量迁移还是一次性全搬? 选了全搬,避免产生大量临时代码。
怎么保证重写后的 Bun 还是原来的 Bun? 保持架构不变,行为不变,用同一套测试套件验证。
具体执行是这样的——50 个动态工作流在 Claude Code 里持续跑了 11 天:
1
2
3
4
5
6
7
8
9
10
# 伪代码
let task;
while ((task = todoList.pop())) {
    const result = task();  // Claude 实现代码
    const feedback = await Promise.all([
        review(result),     // 审查者1
        review(result)      // 审查者2
    ]);
    await apply(feedback, result);
}
对抗式审查:1 个写代码的 + 2 个挑刺的
没有让一个 Claude 又写又审。搞了一个分上下文窗口的对抗机制:
- 1 个实现者:看到原始 Zig 代码、移植方案
- 2 个或更多审查者:只看到 diff,被告知“假设这段代码是错的,找出为什么”
审查者抓到的经典 Bug 示例(异步 close 的 UAF):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// ❌ 编译通过,但会爆炸
for stdio in [spawned_stdout, spawned_stderr] {
    match stdio {
        StdioResult::Buffer(mut pipe) => {
            pipe.close(Subprocess::on_pipe_close)
            // pipe 在 match arm 结束时 drop
            // 但 uv_close 是异步的:libuv 在下一个 loop tick 才回调
            // → libuv 拿着已释放的指针 → use-after-free
        }
    }
}

// ✅ 修复:泄漏所有权给 libuv,回调中重建 Box 释放
let raw = Box::leak(pipe) as *mut uv::Pipe;
unsafe { (*raw).close(Subprocess::on_pipe_close) }

extern "C" fn on_pipe_close(handle: *mut uv::Handle) {
    let raw = handle as *mut uv::Pipe;
    unsafe { drop(Box::from_raw(raw)) }
}
最终的数字
| 指标 | 数值 |
|---|---|
| Zig 代码行数 | 535,496 行 |
| 搬迁耗时 | 11 天 |
| API 成本 | $165,000 |
| 提交数 | 6,502 |
| 输入 token | 59 亿(未缓存) |
| 输出 token | 6.9 亿 |
| 工作流数量 | ~50 个 |
6. 结果与争议:13,000 处 unsafe 的真相
好消息
迁移后的 Rust 版 Bun:
- 二进制体积小了 20%
- 性能快了 5%
- 追踪列表中零未修复内存泄漏
- 全平台测试套件全部通过
坏消息与争议
HN 上有人扒出来了:
- 13,000 处
unsafe——这个数字乍看吓人,但需要客观拆解:
“13,000 处 unsafe”的真相:
- 绝大部分是 FFI 胶水代码:Bun 底层嵌入了 JavaScriptCore(C++)、uWebSockets(C++)、BoringSSL(C)和 SQLite(C)。Rust 调用任何外部 C/C++ 函数都必须用
unsafe包裹。预估其中 90% 以上是纯粹的extern "C" fn声明和指针类型转换,属于调用外部库的必然代价。- 零 Miri 测试:Miri 是 Rust 的未定义行为检测器,一个都没跑。这意味着我们无法区分哪些
unsafe是安全的 FFI 胶水,哪些是真正的逻辑性 UB(未定义行为)地雷。- 暴露了 safe Rust 中的 UB:部分
unsafe块的边界没标对,“safe” 的外壳下藏着不安全的行为。
移除 Zig 文件的 PR #30680 被社区标记为 “AI slop”(AI 垃圾)。
我的判断:机械移植的成功 ≠ 代码质量的成功。 Bun 的测试套件有一百万个断言,这是迁移能成功的核心前提。但这版 Rust 代码目前是 “能跑但 Soundness 未知” 的状态,后续重构的路还长。Jarred 的计划也是这么说的:v1.4 之后再逐步重构,让代码变成地道的 Rust。
7. 反转:Roc 团队用 487 天反着跑
故事到这里,你以为结论是“Rust 赢了,Zig 输了”?没那么简单。
几乎在同一时间,一个叫 Roc 的函数式编程语言,做了一个方向完全相反的决定:把 30 万行 Rust 编译器重写成 Zig。
带头的人叫 Richard Feldman——他是 Roc 语言的创始人和 BDFL(仁慈的独裁者)。他写过 Elm 的经典教材,本身也很喜欢 Rust,还开过 Rust 教学课。
他没有用 AI,没有做机械移植,而是带着团队从零开始,一行一行写了 487 天。
为什么反着跑?
直接原因不是“嫌弃 Rust”,是架构撑不住了。
Roc 有一个很学术的特性叫“多态去函数化”。原来的 Rust 实现里,这类 bug 反反复复出现。后来有人用 OCaml 单独写了个原型,验证出问题根源出在编译器好几个阶段的架构设计上——要修好它,几乎等于重写大半个编译器。
团队一合计:不如干脆做一次彻底的从零重写。
为什么选 Zig 不选 Rust?
Feldman 给了四个理由,每一条都是踩过坑之后的判断:
1. 构建速度:增量编译 Zig 达到 35 毫秒,同期优化后的 Rust 要 3.4 秒——快了约 100 倍。
2. 内存分配器控制粒度:Roc 编译器大量使用 arena。Rust 生态几乎默认“全局只有一个分配器”,而 Zig 的生态天生就是“分配器到处传递”的设计哲学。
3. 生态相关性:编译器这种冷门需求,像“如何绕开 LLVM C++ 库、更快地生成 LLVM bitcode”这类刁钻需求,Zig 那边反而现成的代码更多。
4. 不安全代码的兜底能力——最反直觉的一条:Roc 编译器重写前的 Rust 代码里,unsafe 用了大约 1200 次(30 万行)。比例远高于 rustc 自身。原因很简单:编译器的本质工作就是生成和操作内存不安全的底层表示。 当你大部分代码都在跟裸指针打交道时,Rust 的安全子集价值就大打折扣了。
结果:内存 bug 反而变少了
| 指标 | Rust 版 | Zig 版 |
|---|---|---|
| 内存损坏 bug 总数 | 21 个 | 10 个 |
| 增量编译速度 | 3.4s | 35ms |
Feldman 的结论很克制:
“这不是‘Zig 完胜 Rust’。我仍怀念 Rust 的自动测试内存管理、多态等特性。没有更好的语言,只有更适合具体工程约束的语言。”
8. 性能验证:Bun 真的快吗?(基于 Zig 原版)
以下性能数据基于 Bun v1.3.14(原始 Zig 版本),旨在验证 Bun 作为 JS 运行时的竞争力。Rust 迁移版的额外 5% 提升不在此次本地测试范围内。
我本地装了 Bun 1.3.14 和 Node.js v24.16.0,做了几个简单测试。
测试 1:HTTP 吞吐量(100 并发)
核心逻辑:10000 个请求,分批并发 100。
| 运行时 | 耗时 | RPS |
|---|---|---|
| Node.js | 1621ms | 6171 |
| Bun | 626ms | 15973 |
Bun 快了约 2.59 倍。
测试 2:启动速度:Bun 快约 2.5 倍。
测试 3:包安装速度:Bun 快 10.6 倍。
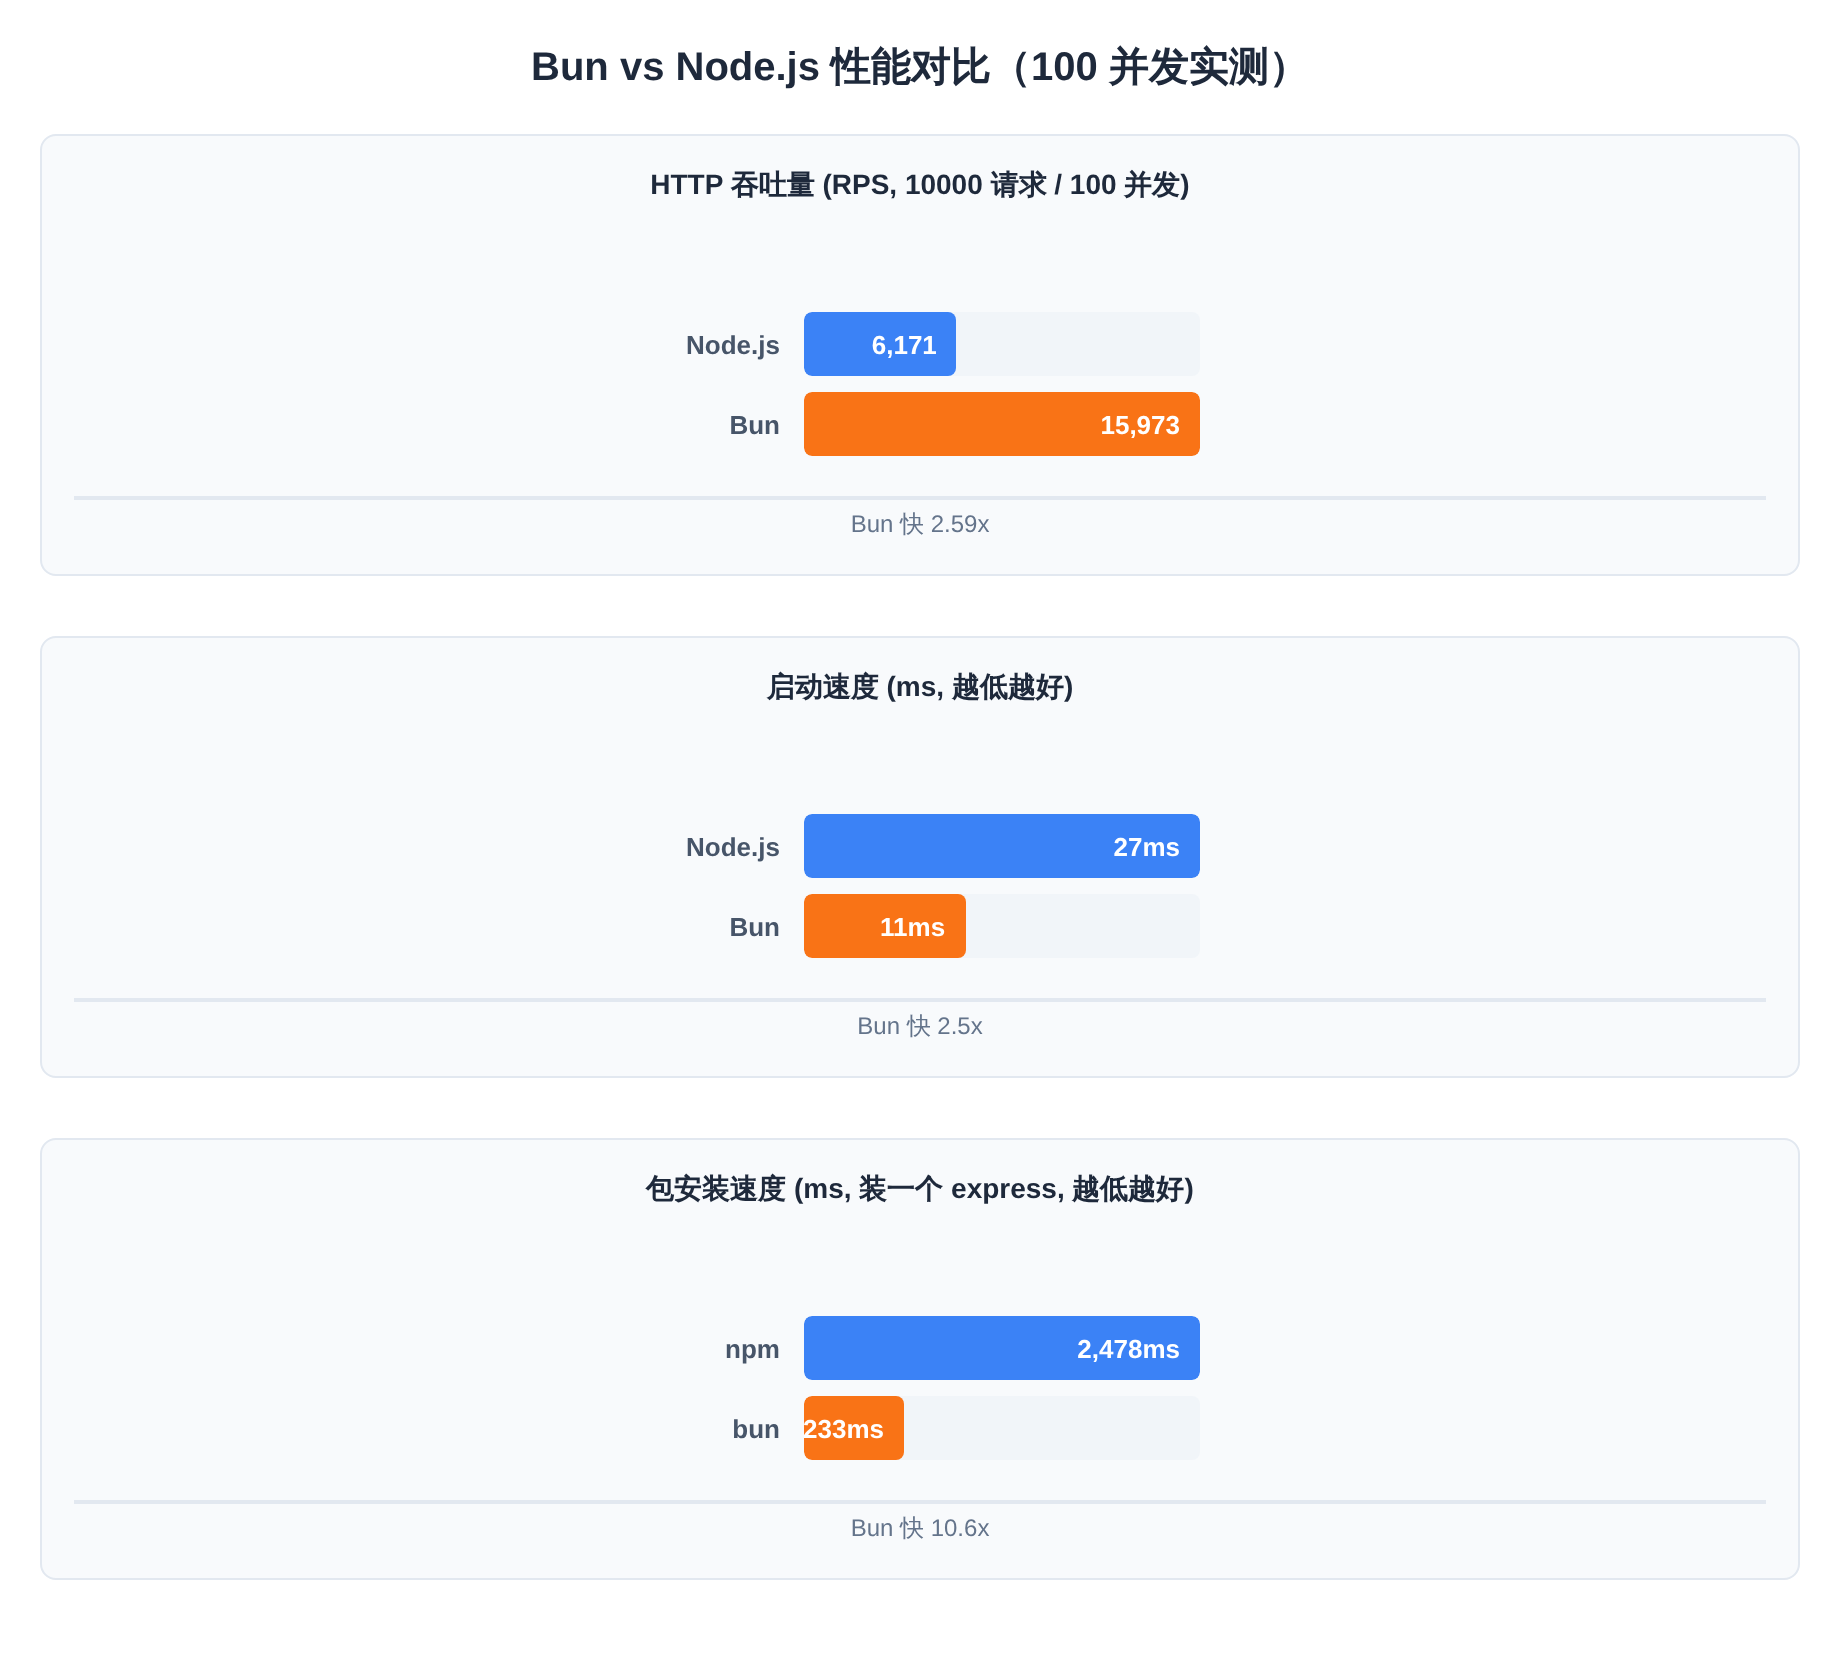
测试结论:Bun 确实快。但这些性能优势来自 JavaScriptCore(vs V8)和底层实现优化,跟用 Zig 还是 Rust 写没关系。迁移到 Rust 后的额外 5% 提升,说明 Rust 的编译器优化(LTO 等)还有额外收益。
9. 核心结论速览(30 秒版)
在进入全景图之前,先看结论:
- Bun 离开 Zig:不是因为 Zig 不好,而是因为“JS-GC + 手动内存”这对组合在大型项目中极易产生 UAF 漏洞。
- Roc 离开 Rust:不是因为 Rust 不好,而是因为编译器充满底层指针操作时,Rust 的 Safe 子集价值衰减,构建速度和分配器灵活性成为主要矛盾。
- AI 迁移的关键:不是 Claude 多聪明,而是 Bun 拥有“百万断言测试”作为安全网,且语义相近的系统语言间移植才可行。
10. JS 工具链重写潮的全景图
| 工具 | 原语言 → 新语言 | 核心原因 | 状态 |
|---|---|---|---|
| TypeScript 7.0 | JS → Go | 编译速度,并行化 | 已发布 |
| React Compiler | JS → Rust | 内存安全,性能 | 已发布 |
| Bun | Zig → Rust | GC+手动内存混合导致 bug 瀑布 | 已合并 |
| Roc | Rust → Zig | 构建速度 100x,unsafe 比例高 | 进行中 |
真正的规律是:
- 从 JS/C++ 转向系统语言(Go/Rust/Zig)
- 选哪个取决于项目特征——TS 选 Go 因为并发模型匹配;Bun 选 Rust 因为需要内存安全保证
- Bun 的迁移不是“Zig 不行”——是“GC + 手动内存管理”这个特定组合不行
- Roc 的反向迁移证明——当项目本身就是内存不安全的(编译器生成机器码),Rust 的 safe 子集价值打折
11. AI 迁移能不能复制?
Bun 的迁移之所以能成,有几个前提条件:
- Bun 有百万断言的测试套件——验证基础
- Zig 和 Rust 都是系统语言,语义相近——机械移植可行
- Jarred 是 Bun 的原作者——能判断 AI 输出对错
- Anthropic 的 Claude Fable 5 预发布版——模型能力的边界突破
对普通团队的启示:
- ✅ 可以学的:对抗式审查模式,PORTING.md 做模式映射
- ❌ 不能照搬的:你没有百万断言测试套件,没有预发布版 Fable 5
- ⚠️ 风险点:13,000 处 unsafe 的代码合并到 main 分支,如果后续没有足够人力重构,就是一个定时炸弹
12. 面试题
题目 1:Bun 为什么从 Zig 迁到 Rust?请从内存管理的角度分析。
答案要点:核心原因是 JavaScript 的 GC 与 Zig 的手动内存管理之间存在结构性矛盾。Rust 的所有权系统和 Drop trait 把“什么时候清理内存”从开发者责任变成了编译器责任,在编译期就能阻止 UAF 和 double-free。
题目 2:Zig 的 defer 和 Rust 的 Drop trait 有什么本质区别?
答案要点:Zig 的 defer 是显式的——时机和逻辑都靠人保证;Rust 的 Drop 触发是自动的(编译器保证时机),但逻辑仍需开发者实现。核心区别在于:defer 靠人保证正确性,Drop 靠编译器保证触发时机。
题目 3:Bun 的 AI 迁移中,“对抗式审查”是怎么工作的?
答案要点:1 个实现者 + 2 个审查者,分上下文窗口运行。实现者看到原始代码,审查者只看到 diff 并被要求“找问题”。分窗口是为了消除 AI 的确认偏误——写代码的 AI 想让代码被接受,审查的 AI 在独立上下文中会更积极地发现 bug。
题目 4:为什么 Roc 编译器反而从 Rust 迁到 Zig?请列举至少两个原因。
答案要点:1. 构建速度(35ms vs 3.4s,快 100 倍);2. 不安全代码比例过高(1200 处 unsafe,safe 子集价值打折);3. 分配器控制(Zig 支持分配器传递,Rust 默认全局单一分配器)。
题目 5:混合 GC 和手动内存管理为什么容易出 bug?请举一个具体场景。
答案要点:典型场景如 UDPSocket.sendMany() 中,JS 层的 valueOf() 回调被 native 调用,但在回调执行过程中 JS 可能 detach 了底层 ArrayBuffer。native 层在回调返回后仍使用之前的指针——此时指针已悬空。
再比如文章中的异步 close 案例(见第 5 节):pipe.close() 传入 C 库的异步回调,但 pipe 在 Rust match 臂结束时就被 drop 了,导致 libuv 拿着悬空指针,回调触发时 UAF 和 double-free。这类 bug 能编译通过,但运行时必定崩溃。
13. 知识图谱(决策树版)
与其画复杂的结构图,不如记住这三条决策路径:
- 项目需要嵌入 JS 引擎(有 GC)? → 优先考虑 Rust(编译期防 UAF 是刚需)。
- 项目在做编译器,整天跟裸指针和 IR 打交道? → Zig 可能更顺手(分配器灵活,构建速度快,没有 safe/unsafe 的割裂感)。
- 项目是纯后端 CRUD 或 CLI 工具? → Go 或 TS 足矣,不必为了炫技上系统语言。
欢迎大家评论和指出意见~
