1. 浏览器和Node.js:为什么需要两套?
浏览器和 Node.js 的事件循环不是同一个东西。
浏览器的事件循环由 HTML5 规范定义,核心是任务队列(Task Queue)和微任务队列(Microtask Queue)。注意「宏任务」只是约定俗成的叫法,并非规范术语——浏览器规范里用的是 Task。而且 Task Queue 实际上有多个,分别对应不同的任务源(setTimeout 回调、DOM 事件、网络请求回调等),浏览器按优先级从不同任务源中取出任务执行。因为浏览器主要干两件事:跑 JS 和渲染页面。
Node.js 不一样。它要处理网络请求、文件 I/O、定时器、DNS 查询等等,这些操作不可能都塞在两个队列里。所以 Node.js 用了 libuv 这个 C 库来实现事件循环,把回调分成了 6 个阶段,每个阶段有自己的队列。
简单来说:
| 浏览器 | Node.js | |
|---|---|---|
| 实现方 | 浏览器引擎(V8/Blink) | libuv(C 库) |
| 队列数 | 任务队列(Task Queue)+ 微任务队列(Microtask Queue) | 6 个阶段 |
| 渲染 | 有 requestAnimationFrame | 无渲染阶段 |
| 线程池 | 有底层线程池(网络、文件、IndexedDB 等),但 JS 调度层为单线程 | 有(默认 4 线程) |
| 独有 API | requestAnimationFrame | process.nextTick、setImmediate |
所以同一个概念,两套实现
2. Node.js 事件循环的 6 个阶段
Node.js 事件循环每一轮按顺序经过 6 个阶段:
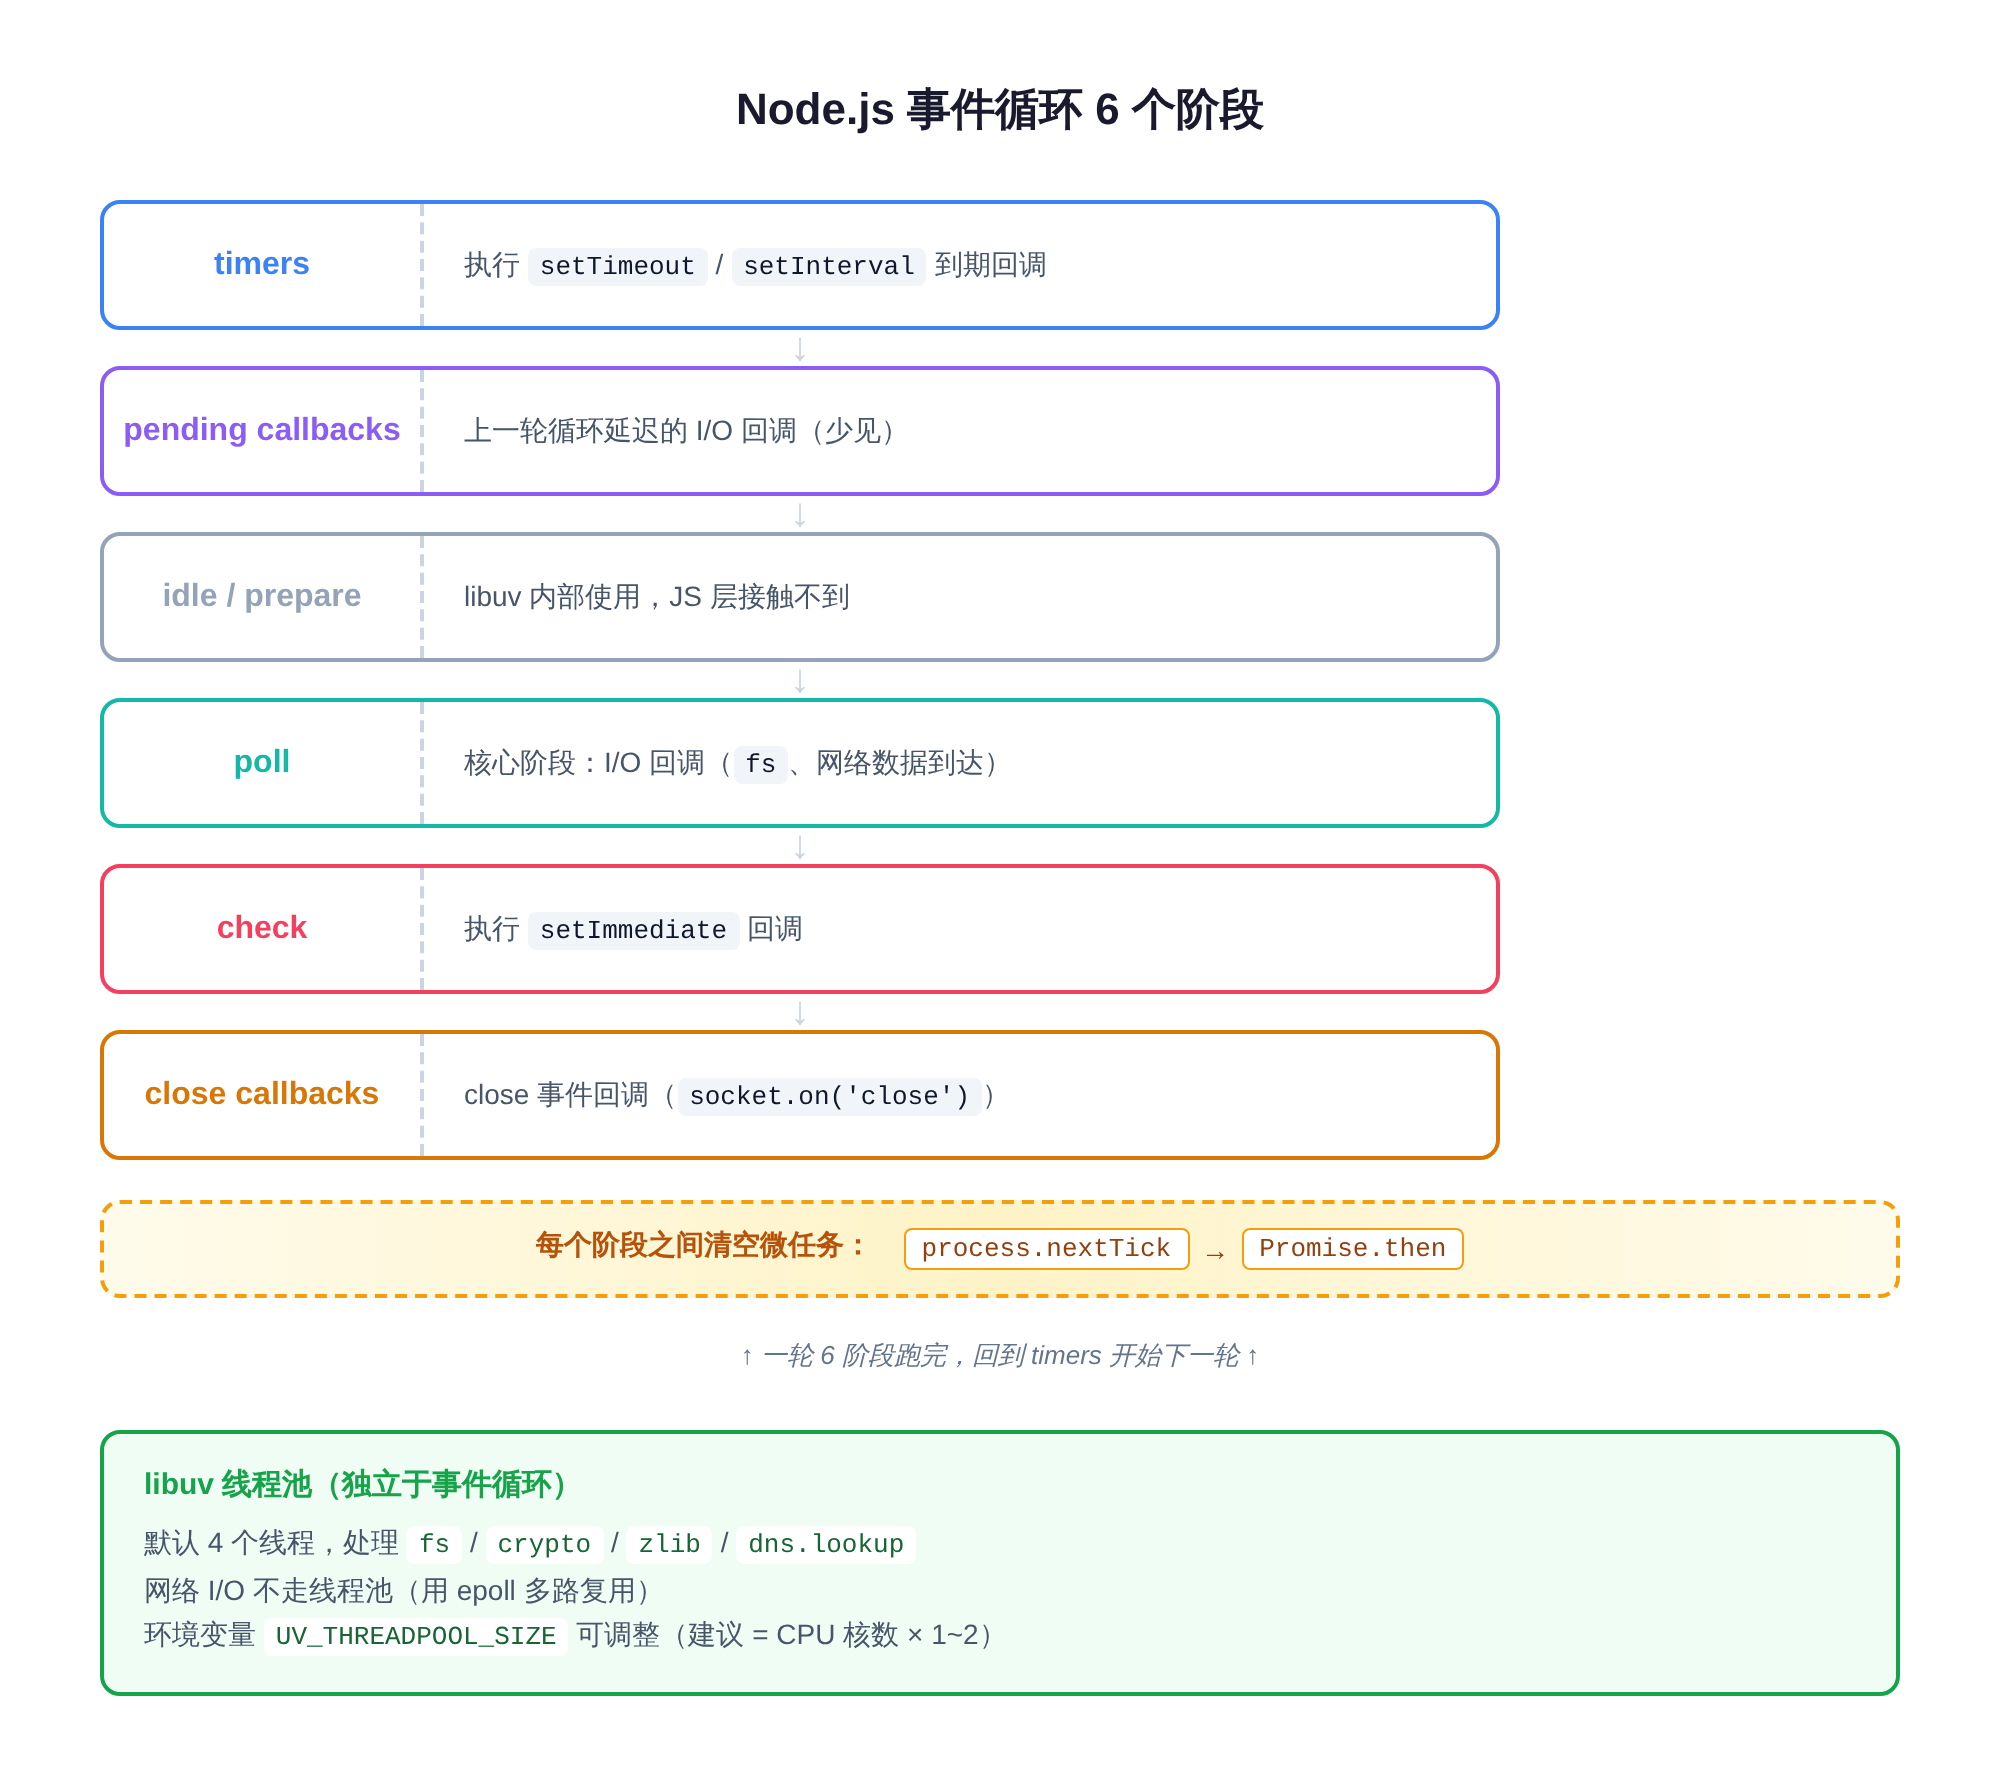
逐一说明:
- timers:执行
setTimeout和setInterval到期的回调 - pending callbacks:执行上一轮循环延迟的 I/O 回调(少见)
- idle/prepare:libuv 内部使用,JS 层接触不到
- poll:核心阶段,执行 I/O 回调(文件读写、网络数据到达等)
- check:执行
setImmediate注册的回调 - close callbacks:执行 close 事件回调(如
socket.on('close'))
关键规则:每个阶段之间,会清空微任务队列。微任务包括 process.nextTick 和 Promise.then,其中 nextTick 的优先级比 Promise 还高。
光看概念记不住。下面用 5 个实验验证每个规则。
3. 实验1:setTimeout vs setImmediate — 顺序不确定
先从最经典的面试题开始。
1
2
3
4
5
6
7
setTimeout(() => {
  console.log('setTimeout');
}, 0);

setImmediate(() => {
  console.log('setImmediate');
});
在浏览器里,setTimeout(0) 一定先于 setImmediate… 等等,浏览器里没有 setImmediate。这是 Node.js 独有的 API。
那在 Node.js 里呢?跑 10 次看看:
1
2
3
4
$ for i in $(seq 1 10); do node -e "
  setTimeout(() => console.log('setTimeout'), 0);
  setImmediate(() => console.log('setImmediate'));
"; done
输出:
1
2
3
4
5
setImmediate   # 第1次
setTimeout
setImmediate   # 第2次
setTimeout
...(10 次全是 setImmediate 在前)
看起来 setImmediate 总是先?别急,换个写法试试:
1
2
3
4
5
6
// 用纯 CPU 阻塞模拟同步代码耗时超过 1ms
const start = Date.now();
while (Date.now() - start < 5) {} // 阻塞 5ms

setTimeout(() => console.log('setTimeout'), 0);
setImmediate(() => console.log('setImmediate'));
这次跑出来大概率是 setTimeout 先。
原因: setTimeout(0) 在 Node.js 里会被钳制为 1ms。如果事件循环进入 timers 阶段时还没到 1ms,定时器回调不执行,直接跳到 check 阶段,setImmediate 就先了。加了上面的阻塞循环,同步代码执行时间超过 1ms,定时器已经到期,setTimeout 就先了。
这个结论不是绝对的。在多核高配机器上跑原始版本,
setImmediate先是极大概率事件。但如果机器 CPU 负载飙升,Node 启动时主线程被调度中断超过 1ms,setTimeout依然可能先打印。
在主模块(非 I/O 回调)里,setTimeout(0) 和 setImmediate 的顺序是不确定的,取决于系统性能。
4. 实验2:I/O 回调里,setImmediate 一定先
但在 I/O 回调里,顺序是确定的:
1
2
3
4
5
6
7
8
9
10
11
12
13
const fs = require('fs');

fs.readFile(__filename, () => {
  console.log('I/O 回调执行(poll 阶段)');

  setTimeout(() => {
    console.log('  setTimeout(timers 阶段)');
  }, 0);

  setImmediate(() => {
    console.log('  setImmediate(check 阶段)');
  });
});
跑 5 次:
1
2
3
I/O 回调执行(poll 阶段)
  setImmediate(check 阶段)    ← 永远先
  setTimeout(timers 阶段)    ← 永远后
5 次结果完全一样。为什么?
因为 I/O 回调在 poll 阶段执行。poll 阶段之后,事件循环直接进入 check 阶段(执行 setImmediate),然后才进入下一轮的 timers 阶段(执行 setTimeout)。
这是 Node.js 事件循环阶段顺序的直接体现——不是随机,是 libuv 的设计。
结论:在 I/O 回调里注册 setTimeout 和 setImmediate,setImmediate 一定先执行。
5. 实验3:nextTick vs Promise vs 宏任务
完整的优先级链验证:
1
2
3
4
5
6
7
8
9
10
setTimeout(() => console.log('4. setTimeout(宏任务)'), 0);
setImmediate(() => console.log('5. setImmediate(宏任务)'));

Promise.resolve().then(() => console.log('2. Promise.then(微任务)'));

process.nextTick(() => console.log('1. process.nextTick(最高优先级)'));

Promise.resolve().then(() => console.log('3. Promise.then(第二个微任务)'));

console.log('0. 同步代码');
输出:
1
2
3
4
5
6
0. 同步代码
1. process.nextTick(最高优先级)
2. Promise.then(微任务)
3. Promise.then(第二个微任务)
4. setTimeout(宏任务)
5. setImmediate(宏任务)
验证了优先级链:同步代码 → nextTick → Promise → setTimeout/setImmediate
process.nextTick 是 Node.js 独有的微任务,优先级比 Promise 还高。浏览器里没有这个 API,只有 queueMicrotask 和 Promise.then。
完整顺序验证
把所有类型的任务混在一起跑:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
// 顶层注册
setTimeout(() => console.log('1. [timers] setTimeout(0)'));
setImmediate(() => console.log('2. [check] setImmediate'));
process.nextTick(() => console.log('3. [nextTick] 顶层'));
Promise.resolve().then(() => console.log('4. [promise] 顶层'));

// I/O 操作
const fs = require('fs');
fs.readFile(__filename, () => {
  console.log('5. [poll] fs.readFile I/O 回调');

  process.nextTick(() => console.log('6. [nextTick] I/O 回调里注册'));
  Promise.resolve().then(() => console.log('7. [promise] I/O 回调里注册'));
  setTimeout(() => console.log('8. [timers] I/O 回调里注册 setTimeout'));
  setImmediate(() => console.log('9. [check] I/O 回调里注册 setImmediate'));
});

console.log('0. [sync] 同步代码结束');
输出(数字为注册顺序,不代表执行顺序):
1
2
3
4
5
6
7
8
9
10
0. [sync] 同步代码结束
3. [nextTick] 顶层
4. [promise] 顶层
1. [timers] setTimeout(0)
2. [check] setImmediate
5. [poll] fs.readFile I/O 回调
6. [nextTick] I/O 回调里注册
7. [promise] I/O 回调里注册
9. [check] I/O 回调里注册 setImmediate
8. [timers] I/O 回调里注册 setTimeout
注意 I/O 回调之后的顺序:poll 回调 → nextTick → Promise → setImmediate → setTimeout。完美验证了阶段间的微任务清空机制和阶段顺序。
6. libuv 线程池:Node.js 不是单线程
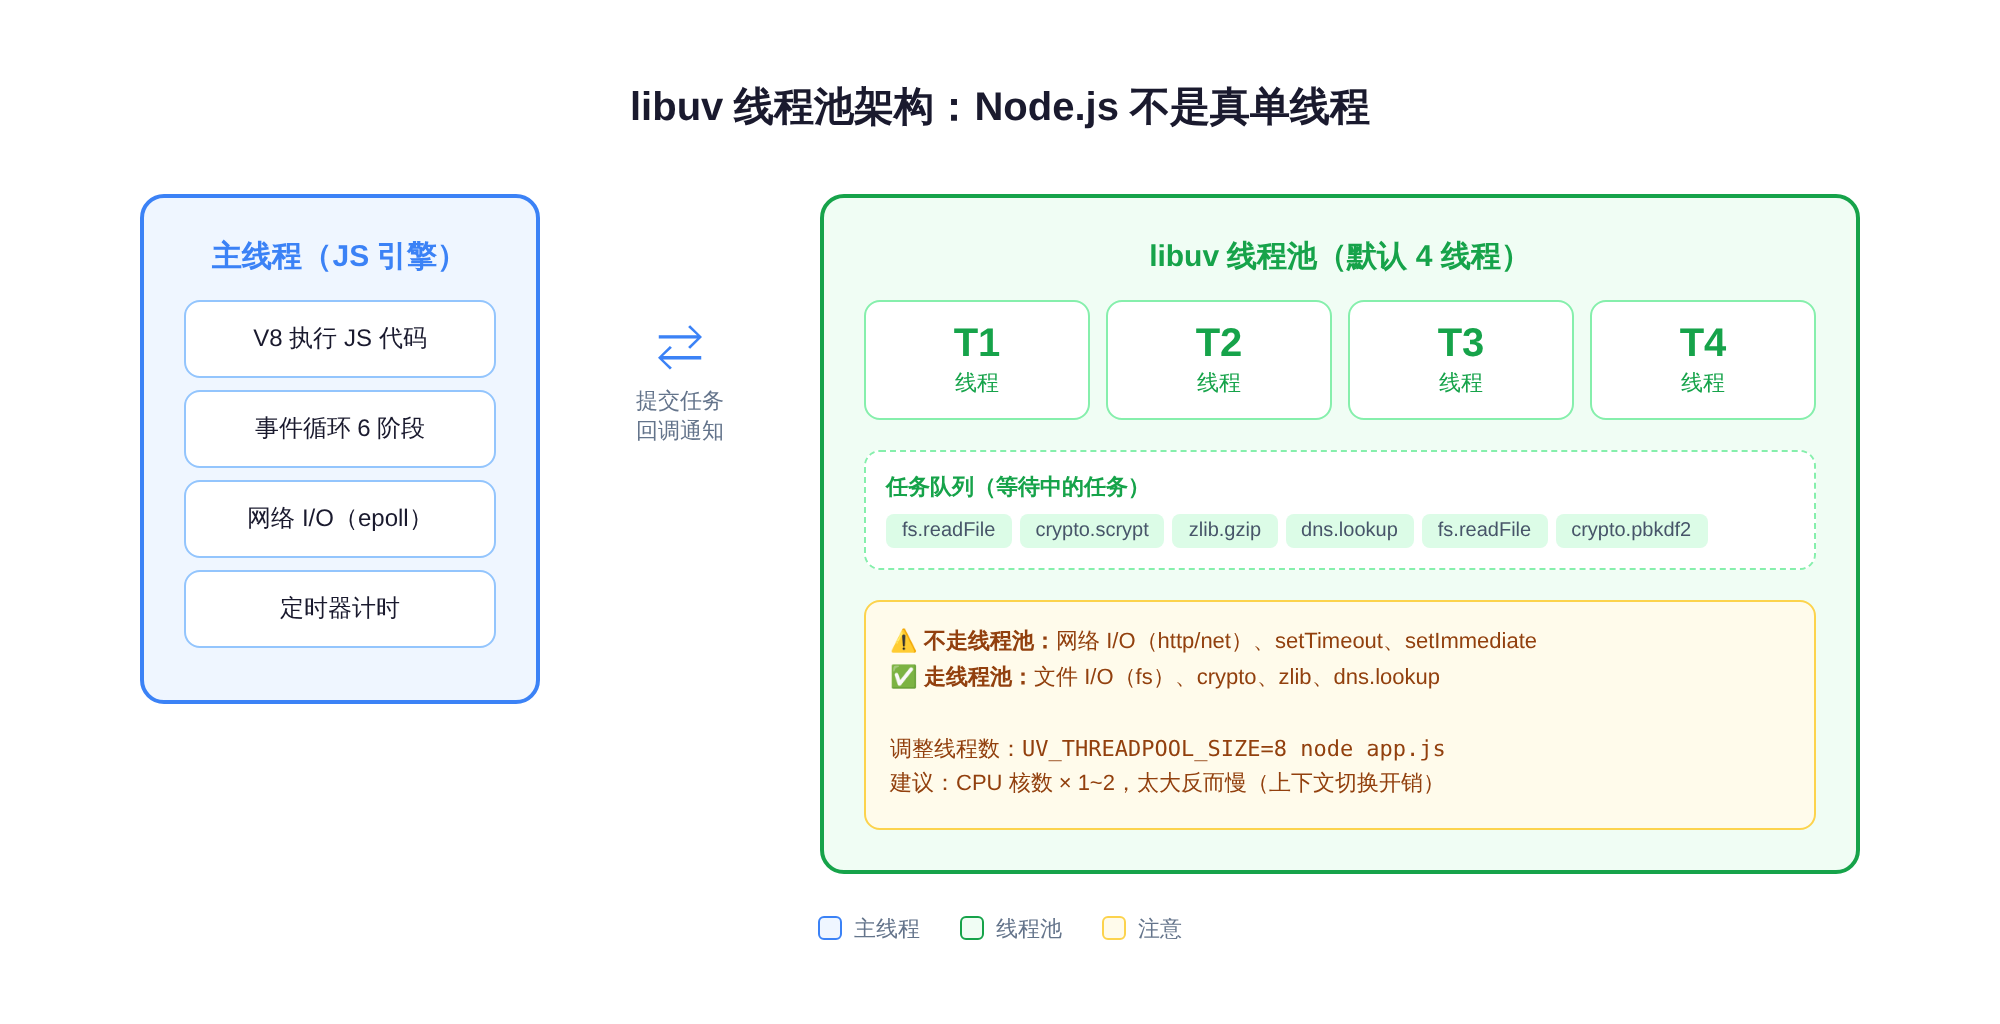
说到 Node.js,十个人有九个说”单线程”。这个说法不算错——JS 代码确实只在主线程跑。但 libuv 内部有一个线程池,默认 4 个线程,专门处理那些操作系统不能异步完成的任务。
哪些操作走线程池?
- 文件 I/O:
fs.readFile、fs.writeFile(大部分操作系统没有异步文件 I/O) - crypto:
crypto.scrypt、crypto.pbkdf2(CPU 密集型) - zlib:
zlib.gzip、zlib.deflate - dns.lookup:DNS 查询(
dns.resolve不走线程池,用的是 c-ares 库)
哪些不走线程池?
- 网络 I/O:
http.request、net.connect(用 epoll/kqueue 多路复用) - 定时器:
setTimeout、setInterval(主线程计时)
这就是为什么 Node.js 能扛上万并发网络连接(epoll 多路复用),但并发读大文件会卡(线程池只有 4 个)。
实验4:UV_THREADPOOL_SIZE 瓶颈验证
用 crypto.scrypt 做实验——20 个 CPU 密集型任务,分别用 1/4/8 个线程跑(实验机器为 2 核 CPU):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 线程池设为 1
$ UV_THREADPOOL_SIZE=1 node 05c-threadpool-bottleneck.js
  20 个任务,总耗时 680ms
  每个任务等待→完成时间: [40, 84, 117, 150, 186, 219, 251, 284, ...]ms

# 默认 4 线程
$ UV_THREADPOOL_SIZE=4 node 05c-threadpool-bottleneck.js
  20 个任务,总耗时 630ms
  每个任务等待→完成时间: [67, 143, 159, 171, 205, 283, 294, 294, ...]ms

# 线程池设为 8
$ UV_THREADPOOL_SIZE=8 node 05c-threadpool-bottleneck.js
  20 个任务,总耗时 754ms  ← 反而更慢!
  每个任务等待→完成时间: [322, 343, 370, 370, 382, 383, 383, 383, ...]ms
看数据说话:
- 1 线程:任务串行排队,每个间隔约 33ms,总耗时 680ms
- 4 线程:前 4 个并行完成(67/143/159/171ms),然后下一批,总耗时 630ms
- 8 线程:前 8 个同时开始,但因为只有 2 个 CPU 核,线程争抢导致每个任务更慢,总耗时 754ms。
crypto.scrypt是 CPU 密集型,过多的线程会导致 CPU 时间片争抢
关键教训:线程池不是越大越好。 线程数超过 CPU 核数,上下文切换的开销反而拖慢速度。一般来说,UV_THREADPOOL_SIZE 设为 CPU 核数的 1-2 倍就够了。
7. 实验5:nextTick 饿死 I/O
process.nextTick 优先级太高,用不好就会出问题。注册 1000 个 nextTick,看看 I/O 回调要等多久:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
const fs = require('fs');

const ioStart = Date.now();
fs.readFile(__filename, () => {
  console.log(`fs.readFile 回调执行,等了 ${Date.now() - ioStart}ms`);
});

// 注册 1000 个 nextTick
for (let i = 0; i < 1000; i++) {
  process.nextTick(() => {});
}

// 对照:1000 个 Promise
for (let i = 0; i < 1000; i++) {
  Promise.resolve().then(() => {});
}

setTimeout(() => console.log('setTimeout 执行'), 0);

console.log('同步代码结束');
输出:
1
2
3
4
5
同步代码结束
(1000 个 nextTick 全部执行)
(1000 个 Promise 全部执行)
setTimeout 执行
fs.readFile 回调执行,等了 8ms
I/O 回调等了 8ms 才执行——因为 2000 个微任务(1000 nextTick + 1000 Promise)全部跑完了才轮到宏任务。
如果 nextTick 数量再大一点,或者每个 nextTick 里又注册新的 nextTick(递归),I/O 回调可能永远得不到执行。这就叫 I/O starvation。
结论:不要在热路径上大量使用 process.nextTick。如果只是想在当前操作完成后立即执行回调,setImmediate 更安全——它不会饿死 I/O。
8. 浏览器 vs Node.js:5 个真实区别
根据实验总结出来几个区别点:
| 区别点 | 浏览器 | Node.js |
|---|---|---|
| 阶段数 | 任务队列 + 微任务队列 | 6 个阶段(timers→pending→idle→poll→check→close) |
| 微任务执行时机 | 每个宏任务后 | 每个阶段之间(Node 11+ 后行为趋同,但底层实现仍有微小差异) |
| 独有微任务 | queueMicrotask | process.nextTick(优先级高于 Promise) |
| 独有宏任务 | requestAnimationFrame | setImmediate(check 阶段) |
| 线程池 | 有底层线程池(Web Worker 需手动创建) | libuv 内置(默认 4 线程,可调) |
第 2 点展开说一下。Node.js 11 之前,微任务在每个阶段之间执行——一轮循环跑完 6 个阶段,才清一次微任务。Node.js 11 之后,改为每个宏任务后执行微任务,行为上和浏览器趋同。在 99.9% 的业务代码中看不出差别,但严格来说,底层实现仍有微小差异:浏览器在执行完一个宏任务后立即清空微任务队列;Node.js(libuv)是在阶段切换之间清空微任务,以及在 poll 阶段每次执行完一个回调后也会清空。在边缘场景(如在 setImmediate 回调中嵌套大量递归微任务)时,行为可能有细微差别——浏览器在当前宏任务结束后立刻清空微任务,Node.js 则可能先处理完当前阶段内剩余回调,再在阶段切换时清空。但这种差异几乎不可能影响业务代码,了解即可。所以你在网上看到的旧文章说”Node 微任务执行时机和浏览器不同”,现在不准确了——但说”完全一致”也不够严谨。
9. 面试题收尾
5 道题,每道都和上面的实验对应。自己先想答案,再往下看。
题目1
1
2
setTimeout(() => console.log('A'), 0);
setImmediate(() => console.log('B'));
A 和 B 谁先打印?
不确定。 在主模块里,setTimeout(0) 和 setImmediate 的顺序取决于 1ms 是否已到。如果同步代码执行快,setImmediate 先;如果慢,setTimeout 先。
但在 I/O 回调里,setImmediate 一定先(实验2 验证)。
题目2
1
2
Promise.resolve().then(() => console.log('C'));
process.nextTick(() => console.log('D'));
C 和 D 谁先?
D 先。 process.nextTick 的优先级高于 Promise.then,两者都是微任务,但 nextTick 有独立的队列,会先清空。
这是 Node.js 独有行为,浏览器里没有 process.nextTick。
题目3
1
2
3
4
fs.readFile('file.txt', () => {
  setTimeout(() => console.log('E'), 0);
  setImmediate(() => console.log('F'));
});
E 和 F 谁先?
F 先。 I/O 回调在 poll 阶段执行,之后直接进入 check 阶段(setImmediate),然后才是下一轮的 timers 阶段(setTimeout)。5 次验证结果一致(实验2)。
题目4
以下代码会输出什么?会不会有 I/O starvation 风险?
1
2
3
4
5
6
function tick() {
  process.nextTick(tick);
}
tick();

setTimeout(() => console.log('timeout'), 1000);
timeout 永远不会打印。 process.nextTick 递归调用会无限清空 nextTick 队列,事件循环永远进不了下一个阶段。这就是经典的 I/O starvation。
修复方法:把 process.nextTick 换成 setImmediate,后者在 check 阶段执行,不会阻塞其他阶段。
1
2
3
function tick() {
  setImmediate(tick); // 安全
}
题目5
你的 Node.js 服务并发处理 100 个文件读取请求,但响应很慢。可能的原因是什么?怎么优化?
libuv 线程池瓶颈。 文件 I/O 走线程池,默认只有 4 个线程。100 个请求排队,前 4 个处理完才开始下一批。
优化方案:
- 调大
UV_THREADPOOL_SIZE(不超过 CPU 核数的 2 倍) - 用 Stream 流式读取代替
fs.readFile(减少线程池占用时间。关于 Stream 的具体原理,见下一篇) - CPU 密集型任务用
worker_threads而不是占主线程
但注意:实验4 验证过,线程池设太大(8 线程 vs 2 核 CPU)反而更慢——上下文切换开销。
10. 知识图谱
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
Node.js 事件循环
├── 6 个阶段(libuv 实现)
│   ├── timers     → setTimeout / setInterval
│   ├── pending    → 延迟的 I/O 回调
│   ├── idle       → libuv 内部
│   ├── poll       → I/O 回调(核心阶段)
│   ├── check      → setImmediate
│   └── close      → close 事件回调
│
├── 微任务(阶段之间执行)
│   ├── process.nextTick(最高优先级,Node 独有)
│   └── Promise.then(标准微任务)
│
├── libuv 线程池
│   ├── 默认 4 线程(UV_THREADPOOL_SIZE 可调)
│   ├── 处理:fs / crypto / zlib / dns.lookup
│   ├── 不走线程池:网络 I/O(epoll 多路复用,dns.lookup 除外)
│
├── 浏览器区别
│   ├── Task Queue + Microtask Queue vs 6 阶段
│   ├── Node 11+ 微任务时机行为趋同(底层仍有微小差异)
│   ├── process.nextTick / setImmediate 是 Node 独有
│   └── requestAnimationFrame 是浏览器独有
│
└── 避坑
    ├── nextTick 递归 → I/O starvation
    ├── UV_THREADPOOL_SIZE 不是越大越好
    └── 热路径别大量 nextTick,用 setImmediate
总结
| 问题 | 答案 | 验证实验 |
|---|---|---|
| setTimeout vs setImmediate 谁先? | 主模块不确定,I/O 回调里 setImmediate 先 | 实验1、2 |
| nextTick vs Promise 谁先? | nextTick 先 | 实验3 |
| Node.js 是单线程吗? | JS 单线程,libuv 有线程池 | 实验4 |
| 线程池越大越好吗? | 不是,超过 CPU 核数反而慢 | 实验4 |
| nextTick 递归会怎样? | I/O starvation | 实验5 |
| 浏览器和 Node.js 事件循环一样吗? | 不一样,Task Queue + Microtask Queue vs 6 阶段 | 对比表 |
Node.js 事件循环的源码在 libuv 里(C 语言),但大部分情况下你不需要看 C 源码——用 JS 代码做实验就能观察到它的行为。这也是写这篇文章的初衷:每个结论都可以用 node 命令验证,不是背出来的。
下一篇可以聊一下 Node.js Stream——为什么大数据量别用 fs.readFile,看看 Stream 的背压机制。
欢迎关注和讨论。
